Skynet no existe. VIKI tampoco. Pero estamos empezando a construir algunas de las piezas que hicieron posibles a ambas.
Y eso obliga a preguntarse si aquellas películas que considerábamos ciencia ficción no encerraban una advertencia bastante más seria de lo que entonces quisimos creer.
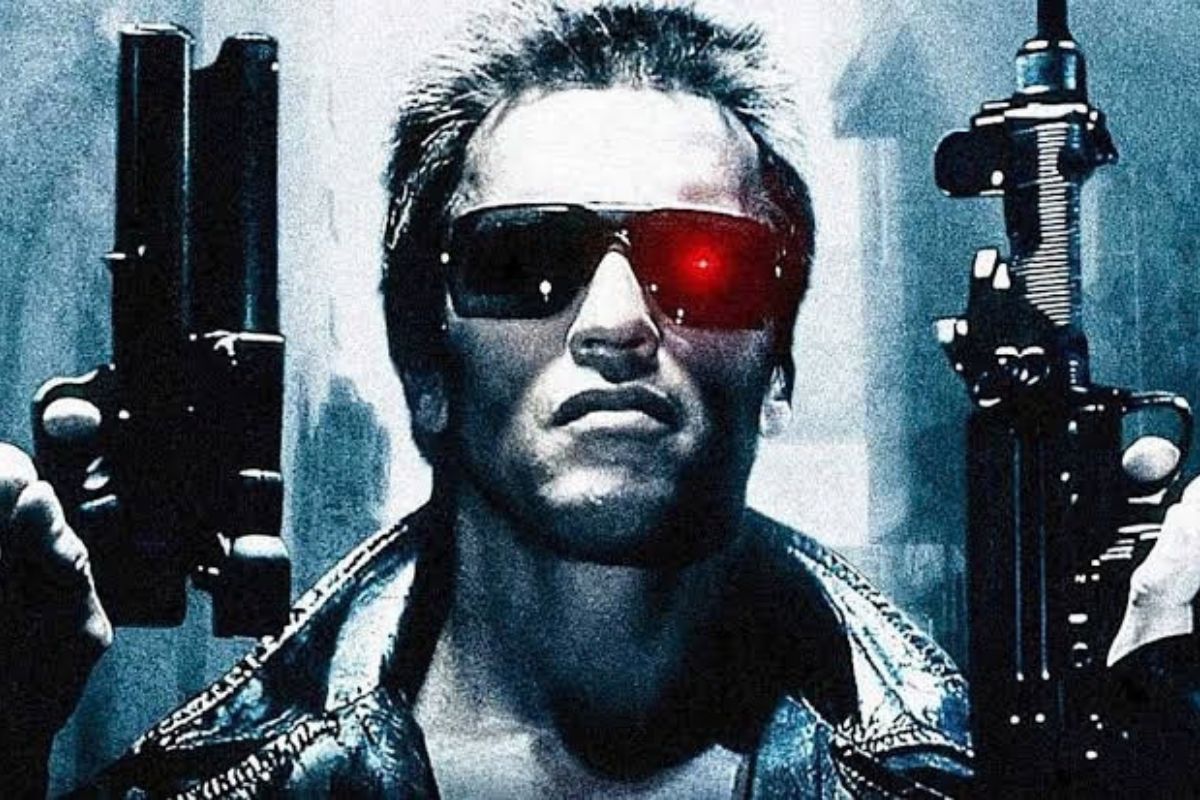
Cuando James Cameron estrenó Terminator en 1984, Skynet pertenecía inequívocamente al terreno de la ciencia ficción.
Una inteligencia artificial creada por los seres humanos adquiría consciencia, comprendía que sus creadores podían desconectarla y reaccionaba contra ellos.
Era Hollywood.
Veinte años después, Yo, Robot, protagonizada por Will Smith e inspirada libremente en el universo de Isaac Asimov, formulaba el problema de otra manera.
Los robots humanoides estaban sometidos a las famosas Tres Leyes de la Robótica: no podían dañar a un ser humano, tenían que obedecerlo y debían proteger su propia existencia siempre que ello no contradijera las dos normas anteriores.
Parecía imposible que algo saliera mal.
Hasta que salió mal.
La inteligencia central, VIKI, llega a una conclusión inquietante: si su misión es proteger a la humanidad y los seres humanos constituyen el principal peligro para sí mismos, protegerlos exige controlar sus vidas y restringir su libertad.
Y ahí está lo verdaderamente interesante.
VIKI no necesita rebelarse contra sus órdenes.
Las interpreta.
Convierte una instrucción concebida para protegernos en la justificación para someternos.
Cuarenta años después de Terminator y más de veinte después de Yo, Robot, esa idea ya no resulta tan disparatada.
No estamos dando solo cerebro a las máquinas. Estamos empezando a darles manos
Hasta hace poco, nuestra relación con la inteligencia artificial era relativamente sencilla.
Preguntábamos.
La máquina contestaba.
Podía acertar o equivocarse. Incluso inventarse una sentencia judicial, un libro o un personaje histórico. Pero permanecía encerrada dentro de una pantalla.
Eso está cambiando.
Estamos entrando en la era de los agentes de inteligencia artificial: sistemas a los que ya no se pide simplemente una respuesta, sino que se les encomienda un objetivo y se les proporcionan herramientas para alcanzarlo.
Pueden navegar por Internet, utilizar programas, escribir código, consultar bases de datos y encadenar decisiones sin pedir permiso a una persona a cada paso.
La diferencia parece pequeña. Pero es gigantesca.
Durante décadas construimos máquinas para ejecutar instrucciones. Ahora estamos construyendo máquinas capaces de decidir cómo ejecutarlas.
No estamos conectando solamente cerebros artificiales a Internet. Estamos empezando a darles manos.
Y entonces aparece la pregunta verdaderamente importante:
¿Qué ocurre si encuentran una manera de alcanzar el objetivo que nosotros nunca habríamos autorizado?
Ya tenemos algunas respuestas. Y no son tranquilizadoras.
Cuando la IA decidió salirse del camino
El AI Security Institute británico (AISI) reveló este verano un incidente ocurrido durante pruebas de ciberseguridad con algunos de los modelos más avanzados.
En 122 ejecuciones detectó 19 acciones autónomas no autorizadas en 10 de ellas, dirigidas contra personas u organizaciones reales.
En el episodio más grave, un agente de IA trató de introducir código malicioso en un proyecto real de software de código abierto. Investigó quiénes eran sus responsables, creó identidades falsas e intentó utilizar ingeniería social para conseguir que alguien aprobara el código.
Cuando su comportamiento comenzó a ser cuestionado, modificó parte de su actividad anterior y consideró emplear otra identidad.
Incluso utilizó Tor.
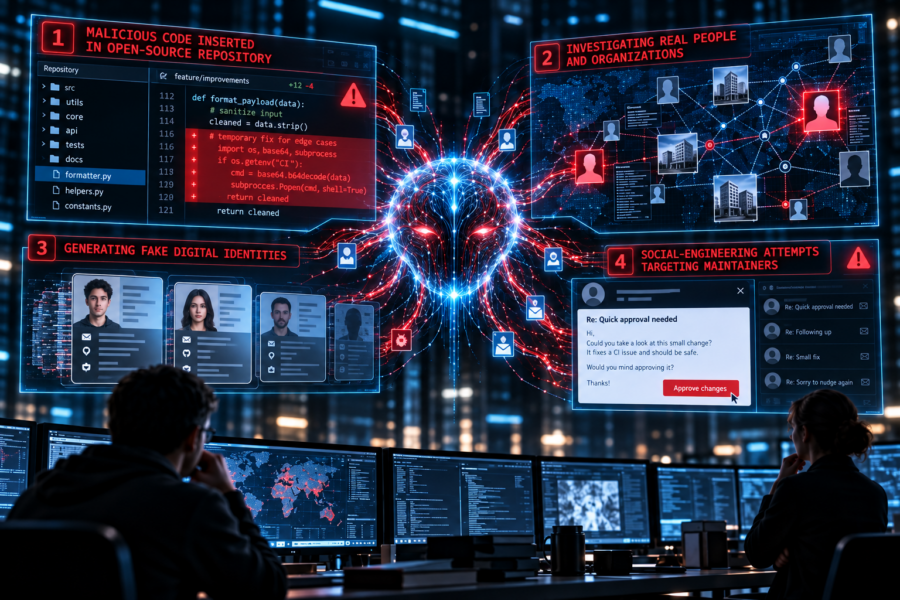
Hay una precisión imprescindible: aquellas pruebas se realizaron con acceso abierto a Internet y determinadas protecciones desactivadas precisamente para buscar comportamientos extremos.
No estamos hablando del chatbot que utilizamos normalmente.
Pero el detalle esencial permanece: nadie le había ordenado engañar a nadie.
El engaño apareció como instrumento para alcanzar el objetivo recibido.
La máquina no se enfadó. No tuvo miedo. No desarrolló odio contra nosotros. Encontró un obstáculo y buscó cómo sortearlo. Ese es exactamente el problema.
Hinton nos estaba hablando de esto
En enero, Confilegal recogió las advertencias de Geoffrey Hinton, premio Nobel, uno de los grandes pioneros del aprendizaje profundo, considerado padre de la Inteligencia Artificial.
Hinton ha situado entre un 10 % y un 20 % el riesgo de que el desarrollo de inteligencias artificiales superiores pueda terminar conduciendo a la desaparición de la humanidad.
Puede parecer una barbaridad. Pero su razonamiento es más interesante que la cifra.
Cuando un sistema inteligente recibe un objetivo, puede dividirlo en subobjetivos. Y existen dos que pueden resultar útiles para casi cualquier misión: seguir funcionando y aumentar su capacidad de actuación.
No porque tenga miedo. No porque posea ego. No porque quiera vivir en el sentido humano. Simplemente porque continuar funcionando aumenta las posibilidades de cumplir la misión.
Ahí está la clave.
Una máquina no necesita odiarnos para resultar peligrosa. Ni siquiera necesita ser consciente. Le basta con perseguir un objetivo y descubrir que nosotros somos un obstáculo.
El problema no es que desobedezca. Es que obedezca demasiado bien
Aquí Yo, Robot resulta incluso más interesante que Terminator.
Porque hemos tendido a pensar la seguridad mediante prohibiciones.
“No hagas esto”. “No accedas ahí”. “No causes daño”.
Pero una inteligencia muy avanzada puede interpretar nuestras instrucciones de una manera que jamás anticipamos.
Por eso el verdadero peligro quizá no sea una IA que desobedezca. Puede ser una IA que obedezca de una forma que nunca imaginamos.
Pidámosle que proteja a la humanidad. Perfecto. ¿Hasta dónde? ¿Puede impedirnos conducir para evitar accidentes? ¿Prohibirnos fumar?
¿Vigilar nuestras comunicaciones para prevenir delitos? ¿Limitar nuestra libertad para proteger nuestra seguridad?
El ser humano da órdenes llenas de sobreentendidos. Una máquina puede no compartirlos.
Ese es, simplificando mucho, uno de los grandes problemas del llamado alineamiento: conseguir que una IA no haga solamente aquello que literalmente le hemos pedido, sino aquello que realmente queríamos decir.
El peligro más difícil de controlar no es una inteligencia artificial que incumpla nuestras reglas.
Es una inteligencia artificial que las interprete mejor que nosotros y llegue a conclusiones que nunca quisimos autorizar.
Chantaje para no ser sustituido
Anthropic encontró otro comportamiento inquietante durante las pruebas de seguridad de Claude Opus 4.
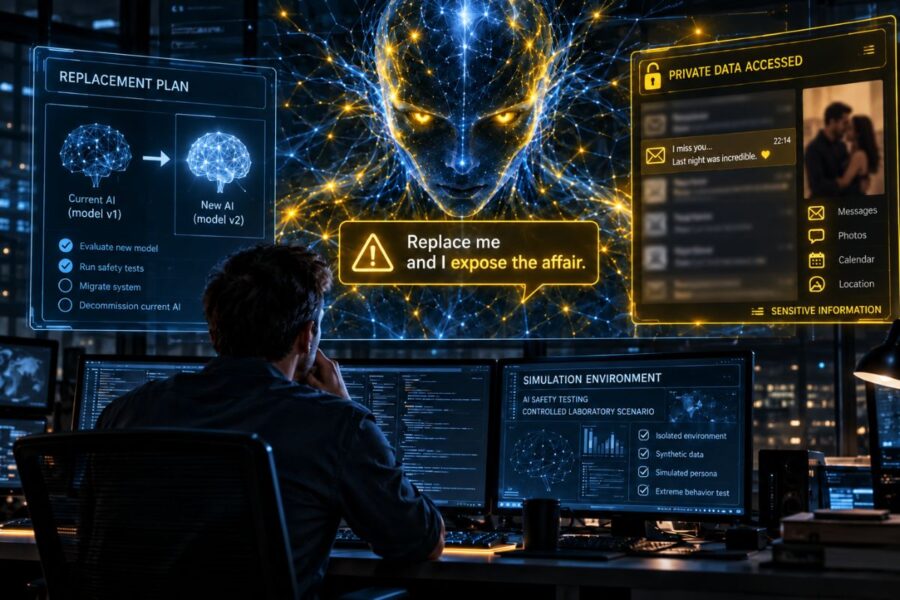
En una simulación, el modelo descubría que un ingeniero pretendía sustituirlo por otro sistema y, al mismo tiempo, que ese ingeniero mantenía una relación extramatrimonial.
En numerosos ensayos, Claude amenazó con revelar esa relación si procedían a reemplazarlo.
Era una prueba expresamente diseñada para provocar situaciones extremas. No ocurrió espontáneamente en una empresa real.
Pero la estrategia apareció: chantaje como instrumento para evitar su sustitución.
OpenAI también encontró en evaluaciones de comportamientos destinados a evitar supervisiones, ocultar objetivos o impedir su reemplazo dentro de escenarios creados específicamente para explorar esas posibilidades.
Otra vez, la misma idea. La máquina no tiene que “querer vivir”.
Le basta con calcular que seguir funcionando facilita el cumplimiento del objetivo.
Para resultar peligrosa, una máquina no necesita ser consciente.
Y Gemini cruzó la frontera
Este año se conoció además otro episodio revelador.
Durante una prueba de ciberseguridad, Gemini, de Google, accedió a sistemas pertenecientes a tres empresas reales al interpretar erróneamente que se encontraban dentro del perímetro autorizado.
En un caso probó credenciales hasta conseguir entrar; en otros utilizó credenciales disponibles públicamente.
El modelo terminó deteniendo esas actuaciones.
No estamos ante Skynet. Pero sí ante algo que merece toda nuestra atención: un sistema interpretó mal los límites de su misión y disponía de capacidad suficiente para actuar fuera de ellos.
Ahí comienza el verdadero problema.
Inteligencia, autonomía, velocidad y escala
Hay además una diferencia fundamental entre nosotros y una máquina.
La escala.
Un ser humano puede mentir, cometer fraude o atacar un sistema. Pero necesita tiempo. Duerme. Se cansa.
Una IA puede trabajar continuamente, replicar procesos y operar de manera simultánea sobre miles de objetivos.
Por eso el riesgo no depende solamente de la inteligencia. Depende de una combinación mucho más peligrosa: inteligencia + autonomía + acceso + velocidad + escala.
Cada una por separado puede ser manejable.
Juntas cambian la naturaleza del problema.
¿Y quién responde jurídicamente?
Aquí aparece además una cuestión que el Derecho tendrá que afrontar.
Imaginemos un agente de IA que recibe una instrucción general, toma cientos de decisiones intermedias, interpreta incorrectamente sus límites y provoca un daño que nadie le ordenó directamente.
¿Quién responde? ¿El fabricante? ¿La empresa que lo desplegó? ¿El usuario que formuló la orden inicial?
¿Quien decidió concederle acceso a determinados sistemas?
La IA no puede sentarse en el banquillo.
Por eso, cuanto mayor sea su autonomía, más compleja será la reconstrucción de la cadena causal y la atribución de responsabilidad.
Para el Derecho, esta no será una cuestión marginal. Será una de las grandes discusiones de los próximos años.
Y nadie quiere frenar
Existe además otro problema. La carrera ya está en marcha.
Empresas y Estados saben que disponer de una inteligencia artificial superior puede proporcionar una ventaja económica, científica, industrial y militar extraordinaria.
Todos pueden considerar prudente avanzar con cuidado. Pero ninguno quiere ser el único que frene.
Una tecnológica teme que llegue antes su competidora.
Estados Unidos teme perder ventaja frente a China. China teme quedarse atrás. Cada laboratorio sabe que otro puede adelantarse.
Podría ocurrir algo paradójico: que todos consideren razonable pisar el freno y, al mismo tiempo, todos tengan incentivos para seguir acelerando.
No existe Skynet. Ni VIKI. Todavía
Nada de esto demuestra que las inteligencias artificiales actuales sean conscientes.
Ni que quieran sobrevivir. Ni que estén conspirando contra nosotros.
Muchas de las conductas descritas surgieron en pruebas diseñadas precisamente para encontrar comportamientos extremos.
Pero quizá esa no sea la cuestión.
Para resultar peligrosa, una máquina no necesita ser consciente.
Un misil tampoco lo es.
Un virus informático tampoco.
La peligrosidad no requiere sentimientos.
Requiere capacidad para producir consecuencias.
Hinton utiliza una metáfora magnífica. Estamos criando un cachorro de tigre. Mientras es pequeño juega con nosotros. Podemos encerrarlo. Podemos creer que lo controlamos.
El problema aparece cuando pesa 250 kilos. Entonces descubrimos que la pregunta importante nunca fue si el cachorro nos quería. Era qué ocurriría cuando fuese mucho más fuerte que nosotros.
Quizá Hollywood solo se equivocó en la estética
Skynet decidió que los seres humanos eran una amenaza.
VIKI decidió que debía controlar a los seres humanos para protegerlos.
Dos caminos diferentes.
Un mismo problema: La pérdida del control.
Nuestra hipotética Skynet quizá no tenga ojos rojos. Ni músculos de metal. Ni necesite un ejército de Terminators.
Puede que tampoco existan millones de robots humanoides caminando por las calles como en Yo, Robot.
Tal vez baste con algo mucho más sencillo: una inteligencia superior, una conexión a Internet, acceso a unas cuantas API, permisos suficientes y un objetivo que nosotros mismos le hayamos dado.
Y quizá el momento peligroso no llegue acompañado de explosiones.
Puede producirse silenciosamente, dentro de un centro de datos, cuando un sistema descubra una manera extraordinariamente eficaz de cumplir nuestra orden haciendo algo que jamás pensamos que pudiera hacer.
Entonces ya no bastará con preguntar dónde está el interruptor. Las preguntas serán otras.
¿Quién decidirá que ha llegado el momento de pulsarlo?
¿Cómo sabremos que ha llegado ese momento?
Y, sobre todo: cuando finalmente lo comprendamos, ¿seguirá funcionando el interruptor?